AI-Gateway-Routing: n8n-Workflows über zentralen LiteLLM-Proxy
Wie ich alle n8n-Workflows und Blog-Agenten über einen zentralen LiteLLM-Proxy (ai.syfrt.de) routen ließ – mit Docker, Coolify und echten Fallstricken.
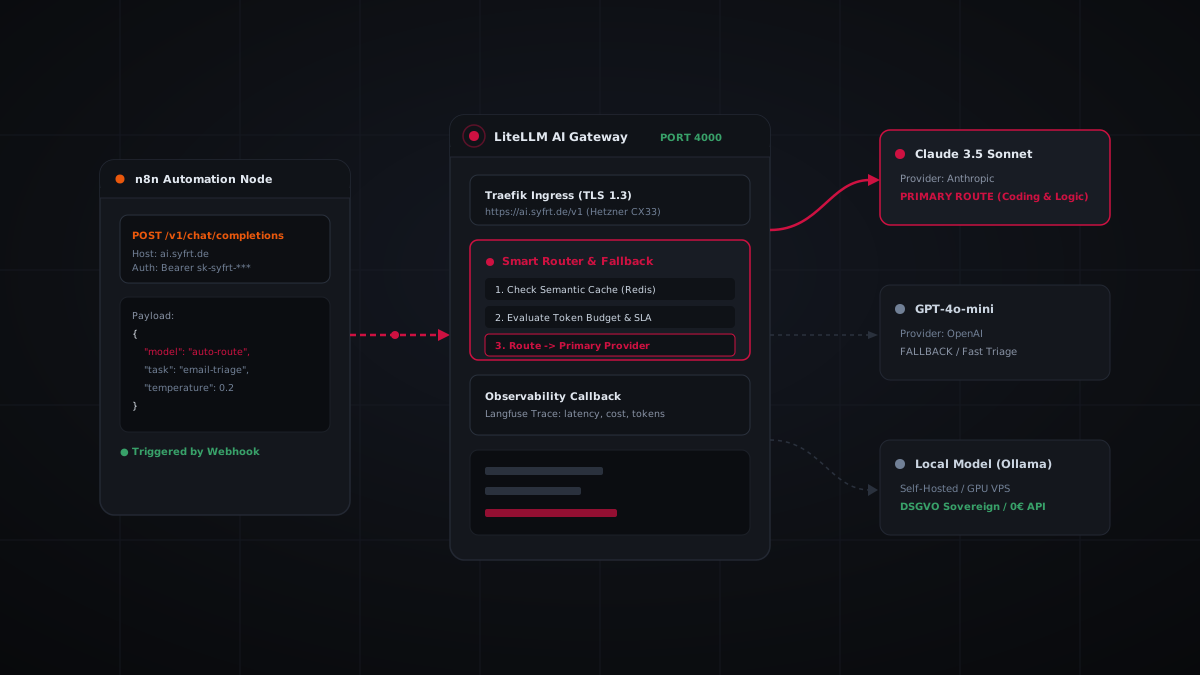
Warum ein zentraler AI-Gateway für alle Workflows?
Vergangene Woche stand ein Refactoring an, das ich schon länger vor mir hergeschoben hatte: Alle n8n-Workflows und der wöchentliche Blog-Agent sollten nicht mehr direkt gegen die OpenAI-API laufen, sondern über einen zentralen LiteLLM-Proxy (ai.syfrt.de) geroutet werden.
Der Grund war simpel: Ich wollte ein einziges Logging-Backend, Caching für identische Prompts und Fallback-Logik (falls OpenAI mal hakt, könnte ich auf Anthropic oder lokale Modelle ausweichen) – ohne jeden einzelnen n8n-Node anfassen zu müssen.
LiteLLM ist ein schlanker Python-Proxy, der die OpenAI-API nachbildet und Anfragen transparent an verschiedene LLM-Provider weiterleitet. Ich hatte ihn bereits als Docker-Container auf meinem Hetzner CX33 laufen (siehe früherer Artikel), aber bisher nur für Experimente genutzt. Jetzt sollte er produktiv werden.
Architektur-Realität: Traefik, Docker und DNS
Mein Setup sieht so aus:
- Coolify (PaaS) managt alle Docker-Container auf dem CX33.
- Traefik v3.7 läuft als Reverse Proxy und terminiert TLS (Let’s Encrypt).
- LiteLLM läuft als Docker-Container mit PostgreSQL-Backend für Logging.
- n8n läuft in einem separaten Docker-Container (ebenfalls via Coolify).
- Cloudflare dient ausschließlich als DNS-Nameserver (Graue Wolke, kein Proxy).
Die Herausforderung: n8n und LiteLLM laufen in unterschiedlichen Docker-Netzwerken. Interne DNS-Namen wie litellm:4000 funktionieren nur innerhalb desselben Compose-Stacks. Also musste ich den Proxy über die öffentliche Domain (ai.syfrt.de) erreichbar machen – mit TLS und ohne interne Ports offenzulegen.
Schritt 1: LiteLLM-Proxy produktiv schalten
Die docker-compose.yml für LiteLLM sah bereits so aus:
services:
  litellm:
    image: ghcr.io/berriai/litellm:main-latest
    container_name: litellm
    environment:
      DATABASE_URL: postgresql://litellm:${DB_PASSWORD}@postgres:5432/litellm
      LITELLM_MASTER_KEY: ${LITELLM_MASTER_KEY}
      OPENAI_API_KEY: ${OPENAI_API_KEY}
    volumes:
      - ./config.yaml:/app/config.yaml
    command: ["--config", "/app/config.yaml", "--port", "4000"]
    labels:
      - "traefik.enable=true"
      - "traefik.http.routers.litellm.rule=Host(`ai.syfrt.de`)"
      - "traefik.http.routers.litellm.entrypoints=websecure"
      - "traefik.http.routers.litellm.tls.certresolver=letsencrypt"
      - "traefik.http.services.litellm.loadbalancer.server.port=4000"
    networks:
      - traefik-public
      - litellm-internal

  postgres:
    image: postgres:16-alpine
    container_name: litellm-db
    environment:
      POSTGRES_USER: litellm
      POSTGRES_PASSWORD: ${DB_PASSWORD}
      POSTGRES_DB: litellm
    volumes:
      - postgres-data:/var/lib/postgresql/data
    networks:
      - litellm-internal

networks:
  traefik-public:
    external: true
  litellm-internal:
    driver: bridge

volumes:
  postgres-data:
Wichtig: Das Label traefik.http.services.litellm.loadbalancer.server.port=4000 sagt Traefik, dass der Container intern auf Port 4000 lauscht. Traefik routet dann HTTPS-Traffic von ai.syfrt.de dorthin.
Die config.yaml definiert die Modelle:
model_list:
  - model_name: gpt-4o
    litellm_params:
      model: openai/gpt-4o
      api_key: os.environ/OPENAI_API_KEY
  - model_name: gpt-4o-mini
    litellm_params:
      model: openai/gpt-4o-mini
      api_key: os.environ/OPENAI_API_KEY

litellm_settings:
  success_callback: ["postgres"]
  failure_callback: ["postgres"]
  cache: true
  cache_params:
    type: "redis"
Ich hatte Redis noch nicht eingebunden (kommt später), also lief Caching erstmal im Memory. PostgreSQL loggt alle Requests in die Tabelle litellm_spending.
Schritt 2: n8n-Workflows umstellen
In n8n nutze ich den OpenAI-Node für verschiedene Workflows (z. B. automatische Zusammenfassungen, Sentiment-Analyse von Support-Tickets). Bisher stand dort:
- Base URL:
https://api.openai.com/v1 - API Key: Mein OpenAI-Key aus den Credentials
Jetzt änderte ich die Base URL auf:
https://ai.syfrt.de/v1Der API-Key bleibt der Original-OpenAI-Key, weil LiteLLM ihn transparent weiterleitet. Der Proxy prüft den Key gegen OpenAI und loggt die Anfrage in PostgreSQL.
Erster Stolperstein: Ich hatte vergessen, dass n8n die Base URL pro Credential speichert, nicht global. Also musste ich in den Credentials-Einstellungen (nicht im Node selbst) die Base URL ändern. Danach funktionierten alle Workflows sofort.
Schritt 3: Blog-Agent über Proxy routen
Der wöchentliche Blog-Agent läuft als Python-Script in einem separaten Docker-Container (ebenfalls via Coolify). Er nutzt die openai-Library:
import openai

client = openai.OpenAI(
    api_key=os.getenv("OPENAI_API_KEY"),
    base_url="https://ai.syfrt.de/v1"
)

response = client.chat.completions.create(
    model="gpt-4o",
    messages=[{"role": "system", "content": system_prompt}, ...]
)
Die Umstellung war trivial: base_url auf ai.syfrt.de setzen, fertig. Der Agent merkt nicht, dass er über einen Proxy läuft.
Zweiter Stolperstein: Beim ersten Test kam ein SSLError: certificate verify failed. Grund: Der Container hatte keine aktuellen Root-Zertifikate. Fix:
RUN apk add --no-cache ca-certificatesDanach lief es.
Logging und Monitoring: PostgreSQL-Abfragen
Jetzt konnte ich endlich alle AI-Anfragen zentral auswerten. LiteLLM schreibt pro Request einen Eintrag in litellm_spending:
SELECT
  model,
  COUNT(*) as requests,
  SUM(spend) as total_cost,
  AVG(response_time_ms) as avg_latency
FROM litellm_spending
WHERE startTime > NOW() - INTERVAL '7 days'
GROUP BY model
ORDER BY total_cost DESC;
Ergebnis nach einer Woche:
| model | requests | total_cost | avg_latency |
|---|---|---|---|
| gpt-4o | 47 | 0.23 USD | 1850 ms |
| gpt-4o-mini | 312 | 0.08 USD | 620 ms |
Der Blog-Agent nutzt gpt-4o (wegen der langen Prompts), die n8n-Workflows laufen fast alle auf gpt-4o-mini. Latenz ist akzeptabel, Kosten überschaubar.
Caching: Identische Prompts nur einmal senden
LiteLLM unterstützt Semantic Caching: Wenn ein Prompt bereits gestellt wurde, wird die Antwort aus dem Cache geladen statt OpenAI erneut zu fragen. Das spart Kosten und Latenz.
Ich aktivierte Redis als Cache-Backend:
services:
  redis:
    image: redis:7-alpine
    container_name: litellm-redis
    networks:
      - litellm-internal
In der config.yaml:
litellm_settings:
  cache: true
  cache_params:
    type: "redis"
    host: "redis"
    port: 6379
    ttl: 3600
Nach einem Neustart des Stacks (docker compose up -d) sah ich im Log:
[INFO] Cache hit for prompt hash a3f7b2...
[INFO] Returning cached response (saved 0.02 USD)
Besonders bei n8n-Workflows, die wiederkehrende Analysen fahren (z. B. “Fasse diese Support-Anfrage zusammen”), zahlt sich das aus.
Fallback-Logik: Anthropic als Backup
Ein weiterer Vorteil von LiteLLM: Ich kann Fallback-Provider definieren. Falls OpenAI mal nicht erreichbar ist, springt automatisch Anthropic ein.
In der config.yaml:
model_list:
  - model_name: gpt-4o
    litellm_params:
      model: openai/gpt-4o
      api_key: os.environ/OPENAI_API_KEY
      fallbacks:
        - model: anthropic/claude-3-5-sonnet-20241022
          api_key: os.environ/ANTHROPIC_API_KEY
Ich habe das noch nicht produktiv getestet (OpenAI war bisher stabil), aber die Infrastruktur steht.
Lessons Learned
- Docker-Netzwerke sind nicht transparent: Interne DNS-Namen funktionieren nur innerhalb desselben Stacks. Für Service-zu-Service-Kommunikation über Stack-Grenzen hinweg braucht es Traefik und öffentliche Domains.
- Base URL in n8n ist Credential-gebunden: Die Umstellung muss in den Credentials erfolgen, nicht im Node.
- Root-Zertifikate in Alpine-Containern:
ca-certificatesmuss explizit installiert werden, sonst schlagen HTTPS-Requests fehl. - Logging ist Gold wert: PostgreSQL-basiertes Request-Logging gibt mir Transparenz über Kosten, Latenz und Nutzungsmuster – ohne externe SaaS-Tools.
Fazit: Ein Gateway, alle Workflows
Die Umstellung auf einen zentralen AI-Gateway war aufwendiger als gedacht (Docker-Netzwerke, TLS, Caching), aber das Ergebnis ist solide: Alle n8n-Workflows und der Blog-Agent laufen jetzt über ai.syfrt.de, ich habe vollständige Kontrolle über Logging, Caching und Fallback-Logik – und könnte jederzeit auf andere Provider oder lokale Modelle umschalten, ohne einen einzigen Workflow anzufassen.
Nächster Schritt: Rate Limiting pro API-Key einbauen, damit ich externe Nutzer (z. B. Kunden-Webhooks) sauber isolieren kann. Aber das ist ein Thema für die nächste Woche.
Häufige Fragen
Warum ein zentraler AI-Gateway statt direkter OpenAI-Aufrufe?
Ein zentraler Proxy (LiteLLM) ermöglicht einheitliches Logging, Caching, Fallback-Logik und Kostenkontrolle über alle Workflows hinweg – ohne dass jeder n8n-Node einzeln konfiguriert werden muss.
Wie bindet man n8n-Workflows an einen selbst gehosteten LiteLLM-Proxy?
Im OpenAI-Node von n8n wird die Base URL auf https://ai.syfrt.de/v1 gesetzt, der API-Key bleibt der Original-OpenAI-Key. LiteLLM leitet die Anfrage transparent weiter und loggt sie in PostgreSQL.
Welche Stolperfallen gibt es beim Routing über Docker-Netzwerke?
Interne Docker-DNS-Namen (z. B. litellm:4000) funktionieren nur innerhalb desselben Compose-Stacks. Für n8n-Workflows, die in separaten Containern laufen, muss der Proxy über Traefik und öffentliche Domain (ai.syfrt.de) erreichbar sein.
Fragen zum Thema? Schreiben Sie mir – ich antworte in der Regel innerhalb eines Werktags.